數據中臺建設的產品方案與路徑參考 從數據處理服務切入的實戰指南
一、為什么數據處理服務是數據中臺的基石
在數據中臺的建設中,數據處理服務往往是最先落地、也最能體現價值的模塊。無論企業的數據規模大小,原始數據總是雜亂、重復、異構的——來自業務數據庫、日志文件、第三方API、IoT設備的數據需要經過采集、清洗、標準化、關聯、聚合等處理,才能成為可被上層分析、算法和業務應用直接使用的“資產”。因此,數據處理服務的設計質量,直接決定了數據中臺的成敗。
許多企業誤以為數據中臺就是買一套大數據平臺或數據倉庫,結果建完后發現數據仍然不可用、口徑混亂、響應慢。根本原因就在于缺乏統一、服務化的數據處理層。本文將從產品方案與實施路徑兩個維度,給出一套可落地的參考框架。
二、數據處理服務的核心產品能力
一個成熟的數據中臺數據處理服務,至少應包含以下六類能力:
1. 數據集成與采集
- 批量集成:支持關系型數據庫、文件系統、HDFS、對象存儲之間的定時抽取與裝載(ETL/ELT)。
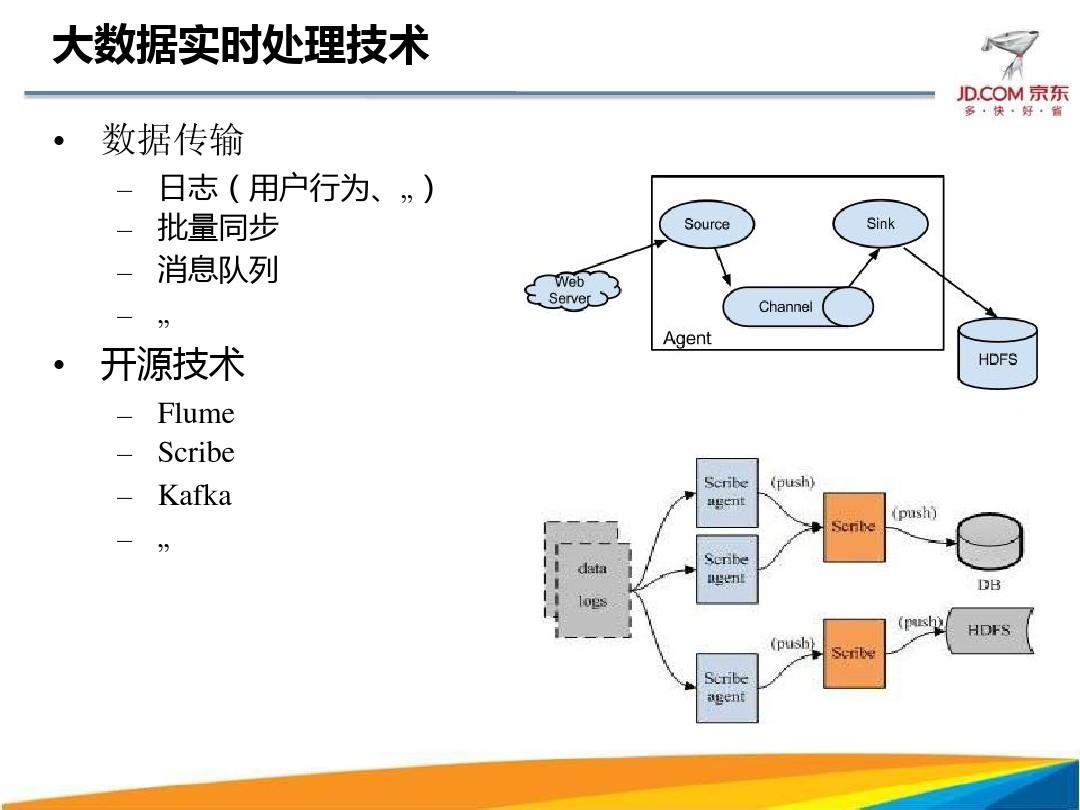
- 實時接入:基于CDC(變更數據捕獲)、消息隊列(Kafka、Pulsar)實現毫秒級數據同步。
- API與流式接入:開放REST/gRPC接口,支持物聯網、埋點、日志等半結構化數據寫入。
2. 數據清洗與標準化
- 去重、空值填充、異常值檢測、格式轉換(日期、編碼、單位)。
- 定義主數據與參考數據,統一客戶、產品、組織等實體的編碼與屬性。
- 支持可配置的清洗規則與正則表達式引擎,降低開發成本。
3. 數據加工與建模
- 批處理:Spark、Hive、MapReduce,用于T+1或小時級聚合。
- 流處理:Flink、Spark Streaming,用于實時指標、告警、風控。
- 統一SQL層:提供標準SQL接口,屏蔽底層引擎差異,支持跨源查詢。
- 維度建模與寬表:構建一致性維度、事實表,形成可直接消費的指標寬表。
4. 數據服務化與API網關
- 將處理后的數據以RESTful API、GraphQL、JDBC/ODBC、消息訂閱等方式暴露。
- 支持接口鑒權、限流、熔斷、審計,確保數據安全與穩定。
- 提供API市場或數據目錄,讓業務方自助查找和申請數據。
5. 任務調度與運維監控
- DAG工作流引擎(Airflow、DolphinScheduler、Azur),支持依賴觸發、重跑、補數。
- 實時監控任務延遲、數據質量、資源消耗,異常自動告警。
- 血緣追蹤:從源系統到目標API的全鏈路影響分析。
6. 數據質量管理
- 六維度規則:完整性、準確性、一致性、及時性、唯一性、有效性。
- 質量分打分與趨勢看板,支持阻斷下游任務或降級服務。
三、產品架構參考分層
建議采用五層架構,自下而上為:
- 基礎設施層:計算(Spark/Flink)、存儲(HDFS/S3/OSS)、資源調度(YARN/K8s)。
- 數據接入層:采集代理、CDC、消息通道、API網關。
- 數據處理層(核心):批流一體引擎、規則引擎、任務調度、元數據管理。
- 數據服務層:統一查詢網關、API管理、數據目錄、權限中心。
- 應用與消費層:BI報表、數據科學平臺、業務系統嵌入、數據產品。
關鍵點是處理層與服務層解耦,前者只負責把數據變“干凈、關聯、可理解”,后者負責把數據變“可調用、可管理、可計量”。
四、建設路徑:三階段演進策略
不建議一次性建設完整中臺,應小步快跑、價值驅動。
階段一:統一數據處理底座(3-6個月)
- 目標:解決最痛的“數據取數慢、口徑亂”問題。
- 做法:
- 選擇一個高價值業務域(如營銷、財務、供應鏈)作為試點。
- 搭建批處理管道,實現從源系統到分析型數據庫的自動同步與輕度清洗。
- 提供基礎API供BI與報表使用。
- 產出:數據處理服務MVP,1-2個核心寬表或指標API。
階段二:平臺化與實時化(6-12個月)
- 目標:形成可復用的數據處理能力,支撐多業務域。
- 做法:
- 引入流處理,補充實時指標與告警場景。
- 建立元數據中心、任務調度平臺、數據質量監控。
- 封裝標準數據處理算子(如窗口聚合、session切割、維度關聯),降低使用門檻。
- 產出:數據處理服務門戶,支持自助配置任務、審批發布。
階段三:數據資產化與智能化(12個月以上)
- 目標:讓數據像水電一樣即取即用,并主動推薦、自動優化。
- 做法:
- 構建數據資產目錄與知識圖譜,自動識別同義字段、推薦 Join 路徑。
- 引入AIOps自動調參、異常檢測、成本優化。
- 對外提供隱私計算、聯邦學習等增強數據處理能力。
- 產出:智能化數據處理引擎,數據服務SLA達99.9%,業務自助率超80%。
五、關鍵成功因素與常見陷阱
成功因素
- 業務牽頭,技術賦能:數據處理服務不能只由IT決定,必須有業務人員參與定義清洗規則與指標口徑。
- 可觀測性優先:每一個處理任務和API都必須有日志、監控、血緣。
- 契約式數據服務:每個接口要有明確的Schema、版本號、SLA。
- 合理的性能與經濟性平衡:不是所有數據都需實時,采用 Lambda 還是 Kappa 架構需按場景選擇。
常見陷阱
- 追求大而全,第一個版本就試圖接入所有數據源 → 工期失控。
- 忽視數據質量,導致上層分析結果不可信,用戶失去信心。
- 將數據處理服務做成點對點的“煙囪式”調用,缺乏統一網關與平臺化入口。
- 不重視元數據與血緣,運維階段無法快速定位問題、評估影響。
六、
數據中臺的本質是通過服務化、標準化、資產化方式釋放數據價值。而數據處理服務作為從原始數據到可用資產的必經管道,它的產品方案與建設路徑直接決定了中臺能否持續贏得業務方的信任。建議以“試點-平臺-資產智能”三部曲推進,強調可觀測性、契約優先和業務共建,從而構建一個真正好用、耐用、能進化的數據處理服務體系。
如若轉載,請注明出處:http://www.taomeishe.cn/product/39.html
更新時間:2026-11-09 15:19:54